- Published on
Capire la matematica alla base delle ZKP
Questo libro è stato tradotto e adattato da Silvio Meneguzzo
Introduzione
In questo articolo spieghiamo la matematica alla base delle Zero Knowledge Proofs (ZKP, dimostrazioni a conoscenza zero), in modo accessibile a uno studente brillante delle superiori o a un laureato STEM (Scienza, Tecnologia, Ingegneria e Matematica) con le nozioni un po' arrugginite. Svilupperai l'intuizione su come funzionano le cose sotto il cofano e costruirai un quadro di riferimento di base per i concetti chiave coinvolti, il tutto accompagnato da un'implementazione giocattolo in meno di 100 righe di codice. Non servono polinomi né curve ellittiche.
Prerequisiti
Diamo per scontate due cose:
- Hai familiarità con le basi delle ZKP. Va bene anche un livello generale, per esempio leggendo un'introduzione semplificata alla Zero Knowledge.
- Non hai paura dei simboli strani (ossia della matematica). Questo testo presuppone che tu sia (a) un laureato STEM 1 che ha seguito un corso di matematica molto tempo fa, oppure (b) uno studente brillante delle superiori a cui piace la matematica. Non ti serve una preparazione formale in informatica, matematica o crittografia.
Il requisito principale è la curiosità e la voglia di imparare. Se ti manca la conoscenza su un argomento specifico, puoi facilmente cercarla 2. Manteniamo deliberatamente ridotti i prerequisiti matematici e ci limitiamo a nozioni di base.
Anche se è utile aver letto entrambi gli articoli precedenti, in senso stretto è richiesto solo il primo.
Quanto alle conoscenze matematiche, ecco le cose di cui idealmente dovresti avere una comprensione di base:
- Sistemi di equazioni (risolvere più di un'equazione alla volta)
- Aritmetica modulare (la matematica dell'orologio)
- Funzioni booleane (AND, OR)
- Funzioni di hash (come SHA256)
- Nozione di casualità (numero casuale)
- Probabilità di base (lancio casuale di una moneta)
- Numeri primi (sapere che esistono)
- Notazione matematica di base (verificare l'uguaglianza; indica l'-esimo pedice)
Anche se non hai dimestichezza con quanto sopra, probabilmente assorbirai i concetti per osmosi.
Panoramica
Ecco una panoramica di come procederemo. Tutti questi concetti saranno introdotti nelle rispettive sezioni, quindi non preoccuparti se per ora questi termini non ti dicono nulla.
Inizieremo passando in rassegna alcuni concetti chiave. Si tratta di mattoni fondamentali come circuiti, completezza funzionale, commitment (impegno crittografico), condivisione del segreto e protocolli sigma.
Dopodiché ci concentreremo su un protocollo ZKP specifico: ZKBoo 3. ZKBoo è un protocollo molto semplice ed è perfetto per sviluppare l'intuizione su come funzionano le cose sotto il cofano. Lo fa senza richiedere una matematica più avanzata, come la crittografia su curve ellittiche.
Inizieremo usando la condivisione del segreto per dimostrare un semplice vincolo (constraint), per poi costruirci sopra, rendendo il protocollo interattivo con un protocollo sigma, rendendolo funzionalmente completo e dimostrando più vincoli. Ne miglioreremo la sicurezza, cioè la solidità, eseguendo il protocollo su più round. Poi lo renderemo non interattivo usando la trasformazione di Fiat-Shamir.
Capirai esattamente come possiamo dimostrare questo insieme di vincoli a un Verifier (verificatore), in un modo che sia solido, non interattivo e che mantenga la conoscenza zero su alcune variabili:
Dopo aver completato il nostro protocollo ZKBoo di base, vedremo come ZKBoo si collega ad altri zkSNARK di cui potresti aver sentito parlare. Vedremo cosa manca a ZKBoo e getteremo le basi per confrontarlo con diversi protocolli ZKP moderni.
Infine, ci sono alcuni argomenti correlati in appendice. Nell'Appendice A vediamo come il nucleo di ZKBoo possa essere implementato in appena ~50 righe di codice usando SageMath 4: incredibilmente compatto. Una versione giocattolo dell'intero protocollo sta comunque in meno di 100 righe. C'è anche un link a un repository di codice su GitHub per approfondire.
L'Appendice B mostra come generalizzare i nostri circuiti booleani in circuiti aritmetici. Nell'Appendice C includiamo alcune definizioni matematiche aggiuntive degli zkSNARK.
Iniziamo.
Concetti chiave
Nella sezione seguente presentiamo alcuni concetti chiave, come circuiti, completezza funzionale, commitment, condivisione del segreto e protocolli sigma.
Circuiti
In una ZKP dimostriamo di conoscere un segreto tale che, applicandovi un certo calcolo, si ottenga uno specifico output, senza rivelare il segreto stesso. Il calcolo è costituito da un insieme di vincoli che devono essere tutti soddisfatti. Possiamo modellarlo come un circuito.
Per esempio, possiamo esprimere un calcolo come il soddisfacimento del seguente insieme di vincoli:
In questo caso, sono input privati, mentre è l'output pubblico 5. è determinato da , ed è quindi una variabile intermedia.
Possiamo visualizzarlo come il seguente circuito:
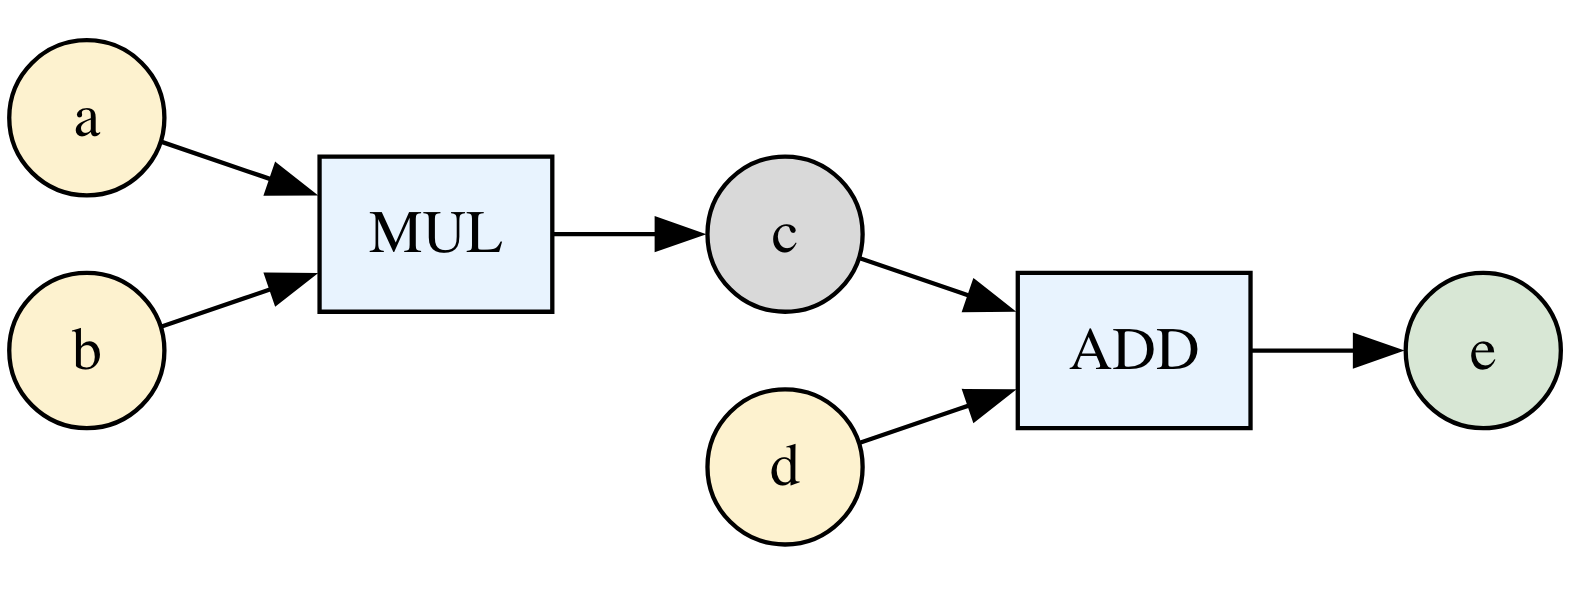
A differenza di un normale programma per computer, i vincoli non sono ordinati. Non importa in quale ordine i vincoli vengano definiti, poiché devono essere tutti soddisfatti 6. Questo significa che, dal punto di vista matematico, non c'è una vera differenza tra input pubblico e output pubblico.
Spesso suddividiamo i diversi tipi di variabili come segue 7:
- Variabili witness (testimone) - variabili private, note solo al Prover (dimostratore)
- Variabili di istanza - variabili pubbliche, di input o di output, note sia al Prover sia al Verifier
Persone diverse usano parole diverse, quindi è utile essere consapevoli dei diversi modi in cui ci si riferisce a queste variabili. Dal punto di vista matematico, possiamo esprimere il circuito qui sopra come:
Dove è la variabile pubblica () e sono le variabili witness (). Ovvero, abbiamo:
Ciò che facciamo quando dimostriamo una ZKP è dimostrare che un insieme di equazioni è valido, senza rivelare informazioni su un insieme di variabili private o sul witness. 8
Completezza funzionale
In che modo colleghiamo le equazioni o i vincoli che stiamo risolvendo a un programma per computer? Il modo più semplice per capirlo è partire dall'esempio più elementare: i circuiti booleani.
Se tutti i valori sono booleani, o , lo chiamiamo circuito booleano. Nell'algebra booleana tutti i valori sono 0 o 1. Possiamo definire semplici gate logici, proprio come in un circuito elettronico (da cui il nome "circuito"). Per esempio, XOR è l'OR esclusivo e può essere illustrato dalla seguente tabella di verità:
Si scopre che ci servono solo due gate logici, XOR e AND, per poter esprimere qualsiasi calcolo possibile. Questo si chiama completezza funzionale 9 e significa che possiamo esprimere qualsiasi tabella di verità con queste sole due operazioni.
Nel circuito menzionato nella sezione precedente ci basiamo su addizione e moltiplicazione. Se operiamo su valori booleani, si scopre che queste sono equivalenti:
Cioè, XOR si comporta come ADD e AND si comporta come MUL. Per esempio, nell'algebra booleana (modulo 2). Analogamente, possiamo esprimere facilmente i gate OR e NAND (NOT-AND) così:
Con semplici gate booleani come questi possiamo costruire un computer moderno. Per capire come sia possibile, esistono un libro e un corso chiamati From Nand to Tetris che mostrano come costruire un computer moderno da zero con un semplice gate booleano NAND. 10
Il sistema ZKP che esamineremo si chiama ZKBoo, definito originariamente per circuiti booleani. Nel testo che segue assumeremo invece circuiti aritmetici che operano su "numeri interi normali" 11. Nell'Appendice B vediamo come possiamo "giustificare" i circuiti aritmetici dal punto di vista matematico. Per ora tutto quello che devi sapere è che possiamo generalizzare quanto sopra, e useremo numeri interi normali ( ecc.) come valori delle nostre variabili.
Commitment
Abbiamo già introdotto i commitment in Programmare le ZKP: From Zero to Hero 12. Qui li ripassiamo brevemente.
I commitment ci permettono di impegnarci ("promettere") su un valore senza rivelarlo. Ci impegniamo in modo tale da non poter cambiare idea su ciò a cui ci siamo impegnati. Esistono molti tipi di commitment, ma il più semplice consiste nell'impegnarsi su un singolo messaggio e nell'usare una funzione di hash come SHA256 per farlo 13.
I commitment hanno due proprietà chiave:
- Binding (vincolante): una volta che ti sei impegnato, non puoi più cambiare idea su ciò a cui ti sei impegnato
- Hiding (occultamento): il commitment non lascia trapelare alcuna informazione sul valore a cui ci siamo impegnati
Ci permettono di eseguire due operazioni:
- Commit (impegno): impegnarsi su un valore specifico mantenendolo nascosto
- Reveal (rivelazione): rivelare il valore in modo che possa essere verificato come corretto (corrispondente a ciò su cui ci eravamo impegnati in precedenza)
Reveal è talvolta chiamato anche "open" nella letteratura crittografica.
Quando ci impegniamo su un messaggio, gli aggiungiamo un po' di casualità. Questo rende più difficile risalire per forza bruta al messaggio sottoposto a hash, nel caso in cui il messaggio sia facile da indovinare. Per esempio, se sai che il messaggio è un numero compreso tra 1 e 100, puoi semplicemente provare tutte le combinazioni finché non ricrei il commitment.
Impegnarsi tramite una funzione di hash potrebbe apparire così:
Qui concateniamo () il messaggio con un po' di casualità . Usare una funzione di hash, come SHA256, garantisce che non possiamo recuperare facilmente il messaggio a partire da .
Più concretamente, potremmo avere:
SHA256('foobar213151') = '419d....1611'
Prendiamo il messaggio foobar, gli aggiungiamo un po' di casualità e otteniamo un commitment, un hash 419d...1611, come risultato. Se diamo questo commitment a qualcun altro, possiamo poi scegliere di rivelare i valori . Quella persona potrà quindi verificare che il nostro commitment corrisponda al nostro messaggio originale .
I commitment sono molto comuni nei protocolli crittografici perché ci permettono di (a) vincolarci ai valori e (b) nasconderli. In particolare, sono una delle componenti chiave di ZKBoo.
Condivisione del segreto
Un'altra componente chiave di ZKBoo è la condivisione del segreto. L'idea chiave è dividere un segreto in più parti, in modo da non poterlo ricostruire senza avere tutte le parti.
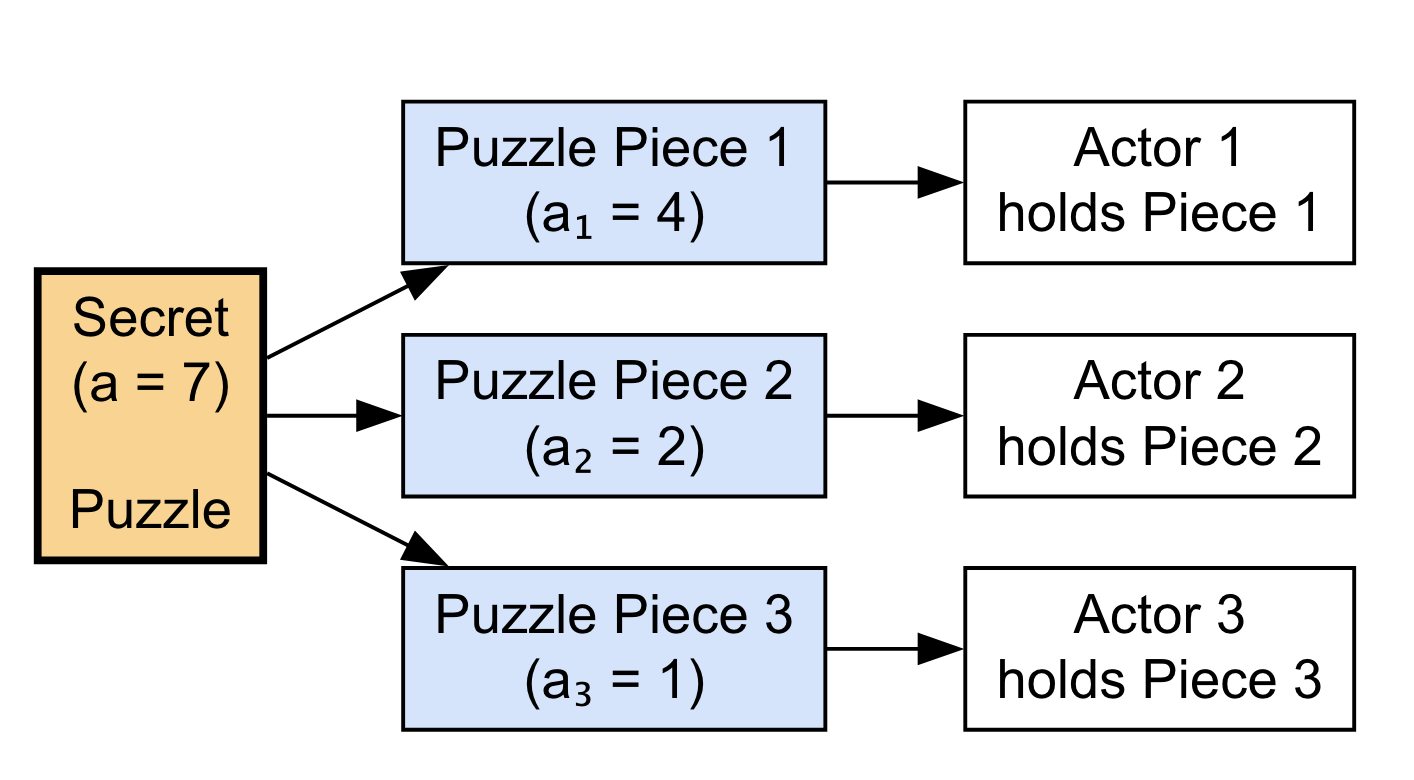
Se abbiamo un valore , possiamo dividerlo come segue: Dove sono valori scelti casualmente la cui somma è .
Se diamo i valori e a qualcuno, questo non ci rivela nulla su cosa siano o . Per esempio, se ho con e ti do e , non c'è modo per te di scoprire quale sia x. Potremmo avere , , ecc. 14
Nel contesto di ZKBoo, questo tipo di condivisione del segreto delle variabili è chiamato anche MPC-in-the-Head. MPC sta per multi-party computation (calcolo multi-party) 15, e tradizionalmente è composto da più attori (persone, server) che si riuniscono per eseguire insieme un calcolo. Anche se l'MPC può diventare piuttosto complesso, in questo caso è "in the head" ("nella testa"), quindi lo stiamo semplicemente simulando nella nostra testa. Puoi immaginare di avere tre attori dentro la tua testa, a ciascuno dei quali dai una quota (share) del segreto. Puoi visualizzare queste quote del segreto come pezzi di un puzzle, e te ne servono tutte per vedere l'immagine completa 16:
Protocollo sigma
Combinando i commitment e la condivisione del segreto in un cosiddetto protocollo sigma, abbiamo tutti gli ingredienti di cui abbiamo bisogno per ZKBoo. Un protocollo sigma è un protocollo composto da due parti, un Prover e un Verifier. Si scambiano tre messaggi, nel seguente ordine: commitment, challenge (sfida) e risposta.
Poiché consiste in interazioni fra due parti, è anche un protocollo interattivo. Si chiama protocollo sigma perché l'interazione ricorda la lettera greca sigma, 17. Un protocollo sigma permette a un Prover di convincere, in modo interattivo, un Verifier che una certa asserzione è vera, senza rivelare alcuna informazione segreta. Puoi pensarlo come una ZKP primitiva.
Impegnandosi prima su alcuni valori, il Prover non può più cambiare idea su quei valori. Successivamente, il Verifier sfida il Prover con una domanda insidiosa. Il Prover risponde, e se il Verifier è soddisfatto della risposta, ne è convinto.
Esistono molti protocolli sigma diversi 18. In generale, hanno tutti le seguenti proprietà chiave 19:
- Completezza: se un Prover conosce la soluzione di un insieme di vincoli, può sempre convincere il Verifier
- Solidità: il Verifier è convinto solo se il Prover conosce davvero il segreto; se il Prover tenta di imbrogliare, la probabilità di riuscirci è trascurabile
- Conoscenza zero: il Verifier non apprende nulla sul segreto del Prover, se non che ha una soluzione valida
Quanto detto sopra potrebbe sembrare un po' astratto, ma diventerà molto più concreto una volta che avremo visto come viene usato in pratica per ZKBoo.
Seguono alcuni semplici esercizi per verificare la tua comprensione.
Esercizi
- In , se è qualcosa che il Prover vuole mantenere segreto, qual è la variabile witness e l'output pubblico?
- Perché l'ordine dei vincoli non ha importanza? Cosa succede se scambiamo l'ordine dei due vincoli riportati sopra?
- Alice si impegna su un numero usando
SHA256(x || r). Se in seguito afferma di essersi impegnata su 42, come può dimostrarlo? - Se Bob divide
x=12in 3 quote tali che , qual è un possibile insieme di valori per ? Perché rivelare e non ci dà alcuna informazione su ? - In un protocollo sigma, perché il Prover deve impegnarsi prima che il Verifier invii il challenge?
ZKBoo
In questa sezione spieghiamo come funziona ZKBoo. Costruiamo gradualmente: da un singolo vincolo di addizione, a più vincoli, fino a un protocollo interattivo completo. Poi lo rendiamo statisticamente solido e, infine, lo rendiamo non interattivo.
ZKBoo è un semplice protocollo ZKP. Si basa su circuiti booleani, commitment, condivisione del segreto (MPC-in-the-Head) e protocolli sigma. Attualmente non è molto usato in pratica, principalmente perché si preferiscono sistemi di dimostrazione con prove più piccole 20. Allora perché impararlo?
È concettualmente molto semplice. Questo significa che puoi capire tutta la matematica che c'è dietro e implementarlo tu stesso. Non richiede né matematica avanzata né molta crittografia per essere compreso a fondo. Questo lo rende ideale per sviluppare l'intuizione su come funziona in pratica la matematica alla base delle ZKP. Una volta compreso un protocollo ZKP nel dettaglio, è molto più facile confrontarlo con altri protocolli ZKP. Lo vedremo verso la fine dell'articolo e nei prossimi articoli. Questo ti aiuterà a prendere decisioni informate su quale protocollo ZKP usare e in quali circostanze.
Dividere le nostre variabili con la condivisione del segreto
Ricorda il sistema di equazioni visto in precedenza:
Per semplificare, concentriamoci sulla dimostrazione di , dove sono privati, mentre è pubblico. Usando la condivisione del segreto, dividiamo ogni variabile in tre quote casuali:
Le quote devono preservare la relazione , ossia per ogni . Nel paradigma MPC-in-the-Head, ogni colonna con pedice corrisponde a un "attore" nella tua testa, che detiene parte del segreto. Possiamo visualizzare le quote del segreto nel seguente formato tabellare:
Ecco come dividiamo queste variabili per ottenere questo risultato:
- Per la prima riga, generiamo casualmente tali che
- Per la seconda riga, facciamo lo stesso per e
- Per la terza riga, poniamo , ed , garantendo che
Se il Verifier sfida il Prover a rivelare due colonne casuali, per esempio , verifica che:
Poiché le quote sono generate casualmente, rivelare due colonne non fornisce alcuna informazione su , pur dimostrando che la relazione è valida.
D'ora in poi non costruiremo più esplicitamente la tabella con righe e colonne, ma potrai sempre disegnarla da solo. Ricorda soltanto che una colonna corrisponde a una quota.
Protocollo sigma per ZKBoo
In quanto Prover, vuoi convincere il Verifier che conosci e che soddisfano l'equazione riportata sopra, senza rivelarli. Ecco come ci riusciremo, con un protocollo sigma.
- Il Prover si impegna su ciascuna colonna, , e invia i commitment al Verifier
- Il Verifier sfida il Prover chiedendogli di rivelare due colonne,
- Il Prover risponde con i valori delle colonne richieste dal Verifier
Una volta che il Verifier dispone di questi valori, effettua due verifiche:
- Verifica di coerenza: controlla che i valori tornino, ad es.
- Verifica del commitment: controlla che i commitment corrispondano ai valori forniti dal Prover nella risposta
Se entrambe le verifiche vanno a buon fine, il Verifier è ragionevolmente convinto 21 che il Prover conosca e . Quando si impegna, il Prover usa anche un po' di casualità per garantire che non si possa risalire per forza bruta ai valori. Sfruttando le proprietà di hiding dei commitment e della condivisione del segreto, il Prover non rivela nulla su e stessi.
Ecco un diagramma di questo protocollo sigma:
In questo modo otteniamo le tre proprietà a cui teniamo:
- Completezza - il Prover conosce una soluzione e può sempre convincere il Verifier
- Solidità - il Verifier è convinto solo se il Prover conosce davvero il segreto (vedremo tra poco il caso in cui il Prover sta imbrogliando)
- Conoscenza zero - il Verifier non apprende nulla su e (a parte che sommati danno )
Sebbene impegnarsi sui valori colonna per colonna significhi che il Prover non può cambiare idea in seguito sul contenuto di quelle colonne, restano comunque alcuni problemi. E se il Prover indovinasse con quali colonne lo sfiderà il Verifier? Ci sono solo tre opzioni possibili: . Se così fosse, potrebbe imbrogliare assicurandosi soltanto che quelle colonne tornino, senza conoscere e . Questo significa che c'è una probabilità di ben di imbrogliare!
Questo riguarda la natura statistica della solidità. Nella pratica crittografica, le probabilità svolgono spesso un ruolo nel garantire la sicurezza. L'obiettivo è ridurre il rischio di imbroglio a un livello trascurabile (anzi, astronomicamente trascurabile). Vedremo presto come farlo, usando più round del protocollo.
Ma prima, vediamo come gestiamo la moltiplicazione e i vincoli multipli.
Supportare la moltiplicazione
Torniamo al nostro insieme originale di vincoli:
L'addizione, come , era abbastanza semplice. E la moltiplicazione? Vogliamo scomporre la relazione in quote del segreto. Come possiamo farlo?
Notiamo innanzitutto quanto segue. Se dividiamo ingenuamente e poniamo , questo non funziona. Perché?
Questo accade perché la moltiplicazione non è lineare, quindi otteniamo termini incrociati:
Dobbiamo trovare un modo migliore di assegnare per mantenere coerenti le relazioni. Possiamo farlo distribuendo in modo uniforme i termini incrociati su ciascuna quota 22:
Ora la relazione vale. Abbiamo:
C'è però un nuovo problema. Rivelando due colonne, diciamo , lasciamo trapelare informazioni sulla terza. Con riveliamo alcune informazioni sulla terza colonna attraverso i fattori . A seconda di cosa rappresentano i valori, il Verifier potrebbe essere in grado di dedurre quali siano e .
Possiamo aggirare il problema aggiungendo un po' di casualità:
Ora, abbiamo ancora , perché tutte le variabili casuali si annullano a vicenda:
Aggiungendo un po' di casualità, non riveliamo alcuna informazione sulla terza colonna. Stiamo quindi usando la casualità per mascherare informazioni sensibili, un trucco comune nella crittografia.
Dove "appartengono" ? Li aggiungiamo come un'altra variabile. In forma di tabella con righe e colonne, abbiamo:
dove , e sono impostati come sopra. Nota come rivelare le colonne riveli e ma lasci sconosciuto, mascherando così il valore della terza colonna.
Mettere tutto insieme
Infine, per combinare quanto visto sopra con l'insieme originale di vincoli:
In quanto Prover:
- Impostiamo casualmente le quote di , come sopra
- Impostiamo in modo che , e lo stesso vale per tutte le quote
- Impostiamo in modo che , e analogamente per tutte le sue quote
Ecco il nostro protocollo sigma aggiornato con commitment-challenge-risposta:
Il Verifier esegue (a) verifiche di coerenza e (b) verifiche del commitment.
Verifica di coerenza per ogni vincolo:
- Verifica per le quote:
- ,
- Nota che i pedici di sono
- Verifica per le quote:
Verifiche del commitment:
Qui sopra, corrisponde alla -esima colonna, che non viene rivelata. A seconda di come eseguiamo più round del protocollo, questo valore può essere rivelato oppure no. Verifichiamo comunque , poiché le colonne -esima e -esima vengono rivelate.
Con questo, abbiamo dimostrato un insieme di vincoli usando addizione e moltiplicazione, mostrando così la completezza funzionale. L'abbiamo fatto in un modo che ha mantenuto privati i valori privati e ha convinto il Verifier che il Prover li conosce. Vedremo ora come migliorare la solidità, eseguendo il protocollo su più round.
Migliorare la solidità
Diamo un'occhiata più critica al protocollo sigma che abbiamo specificato sopra. E se il Prover imbrogliasse? Supponiamo che indovini che il Verifier sceglierà le colonne . A quel punto non deve realmente conoscere i valori privati. Per esempio, in non deve conoscere o , o . Può semplicemente inventarsi dei valori che facciano passare la verifica di coerenza. Questo perché il Verifier controlla solo la seconda e la terza colonna.
Ricorda le verifiche che il Verifier esegue:
- Verifica di coerenza:
- Verifica del commitment:
Più concretamente, possiamo semplicemente scegliere valori casuali per tali che , e lo stesso per . Questo non richiede alcuna conoscenza di o . Supponendo che il Prover pensi che verrà scelta , allora il Verifier verifica solo che e . Questo non va bene.
Naturalmente, grazie ai commitment, il Prover non può cambiare idea. Se non avessimo questa verifica del commitment, potrebbe imbrogliare ogni singola volta. È per questo che abbiamo bisogno della proprietà di binding dei commitment, ed è per questo che il commitment viene comunicato prima che il Verifier decida quali quote esaminare.
Qual è la probabilità di indovinare correttamente? Ci sono tre modi di scegliere due colonne: . Questo significa che c'è una probabilità di di imbrogliare 23. È quello che chiamiamo errore di solidità. Vorremmo ridurre questo errore a una probabilità molto più piccola.
Come possiamo farlo? Si scopre che possiamo farlo eseguendo il protocollo sigma su più round. Ogni volta il Verifier sceglie un nuovo insieme di due quote casuali. Naturalmente, dopo che il Verifier ha scelto, ad esempio, e , conosce i valori di tutte e tre le quote e può facilmente ricostruire i valori originali di e , il che non va bene.
Il modo in cui aggiriamo questo problema, mantenendo comunque bassa la probabilità di imbrogliare, è creare nuove quote del segreto a ogni round. Per una data variabile, la dividiamo come , dove sono valori casuali che soddisfano l'equazione. Facciamo questo per ogni variabile. Il Verifier invia il challenge, chiedendo due quote, ed esegue le verifiche di coerenza e del commitment. Nel round successivo, usiamo ancora nuove quote casuali per dividere le nostre variabili. In questo modo, il Verifier non può combinare le informazioni ricevute nei diversi round, perché tutto ciò che vede sono quote casuali diverse.
Con questo, qual è la probabilità di imbrogliare? Per il vincolo di addizione sopra, a ogni esecuzione la probabilità è , e se facciamo esecuzioni otteniamo:
Se è sufficientemente grande, la probabilità di imbrogliare è trascurabile. Per esempio, se eseguiamo 100 round otteniamo una probabilità di . Questo è estremamente basso. Per maggiore sicurezza, possiamo semplicemente eseguire più round. Per maggiori dettagli sull'errore di solidità, vedi la nota 24.
Sebbene questo sia molto più sicuro, richiede molte interazioni tra il Prover e il Verifier. Per ogni round dobbiamo inviare 3 messaggi, e per 100 round sono 300 messaggi avanti e indietro! Questo non è molto pratico nel mondo reale. Per affrontare il problema, vediamo come possiamo rendere questo protocollo non interattivo, riducendolo a un singolo messaggio con l'uso della trasformazione di Fiat-Shamir.
Trasformazione di Fiat-Shamir
Siamo riusciti a rendere il protocollo statisticamente sicuro eseguendo più round. Ecco il protocollo sigma che avevamo per un singolo round:
L'obiettivo della trasformazione di Fiat-Shamir è trasformare questo protocollo interattivo in uno non interattivo, in cui il Prover invia un unico messaggio, una prova, e il Verifier ha tutte le informazioni di cui ha bisogno per verificare la prova.
Perché mai il Verifier invia il challenge dopo i commitment? Perché non vuole che il Prover cambi idea e imbrogli scegliendo le colonne autonomamente. Questo comprometterebbe la solidità. Dal punto di vista del Prover, questa selezione è casuale. Possiamo ottenere questa casualità da qualche altra parte? Senza che sia il Verifier a generarla?
Entra in gioco la trasformazione di Fiat-Shamir. L'idea chiave è sostituire la casualità utilizzata dal Verifier con una funzione di hash deterministica. Poiché le funzioni di hash sono pseudo-casuali 25, possiamo usarle per generare un numero casuale, che viene poi utilizzato per selezionare casualmente due colonne.
A grandi linee, invece di questo:
Facciamo così:
Il challenge dovrebbe essere prodotto con un hash e includere i commitment oltre a qualche informazione pubblica. È qualcosa su cui Prover e Verifier concordano silenziosamente, non qualcosa che il Prover può decidere da solo. Anzi, non abbiamo nemmeno bisogno di inviare il challenge, dato che può essere calcolato da entrambe le parti. Il Prover crea i commitment, calcola i challenge e le risposte (tutto localmente) e li invia al Verifier. Il Verifier annota quindi i commitment, ricalcola il challenge da solo e verifica risposte e commitment.
Come viene calcolato il challenge? Perché funziona? Come input per il nostro hash usiamo alcune informazioni pubbliche, che fungono da "seed (seme) casuale" 26, il cui output non è controllato né dal Prover né dal pubblico. Questo significa che non dobbiamo comunicare questa informazione, ma possiamo semplicemente calcolare questa fonte di casualità in autonomia. Ecco come potrebbe apparire il challenge in pratica:
Aggiungendo alcune informazioni pubbliche <public info>, come il nome del circuito (ad es. zkboo-example) e l'input pubblico (ad es. il valore di e, 5), il Prover non controlla da sé tutto l'input della funzione di hash. È inoltre fondamentale includere tutti i commitment come input di questa funzione di hash, in modo che il Prover non possa cambiare idea su ciò a cui si è impegnato. Poiché le funzioni di hash come SHA256 sono deterministiche, il Verifier ricreerà lo stesso challenge, purché abbia accesso a tutto il suo input.
Nel nostro caso, il Verifier sceglie due colonne su 3. Ci sono tre possibilità, quindi possiamo semplicemente prendere il nostro hash casuale ed eseguire su di esso per ottenere una selezione delle colonne in modo deterministico.
Se eseguiamo un solo round, per il Prover è piuttosto facile imbrogliare semplicemente indovinando quali colonne verranno scelte, creando i commitment e calcolando il challenge. Se il challenge fa sì che "indovini correttamente", allora può creare una prova falsa. Se non ci riesce, può modificare gli input per creare commitment leggermente diversi, e sperare di essere fortunato alla prossima esecuzione dell'hash. Dopotutto, tutto questo avviene in locale, quindi il Verifier non ne è al corrente.
Ecco perché è fondamentale eseguire più round del protocollo. Nello specifico, dobbiamo usare ogni round precedente come input per il challenge del round successivo. Solo così possiamo ottenere le stesse garanzie di solidità 27.
Per garantire la solidità, il challenge di ogni round deve dipendere da tutti i commitment precedenti. Questo impedisce al Prover di fare "backtracking" per generare risultati favorevoli. Calcoliamo il challenge per il round come segue:
Dove è il commitment per il round -esimo della quota , e <public info> è un segnaposto per una conoscenza pubblica condivisa e predeterminata. Aggiungendo garantiamo che ogni round abbia un challenge univoco, anche se i commitment e le informazioni pubbliche si ripetono. Le informazioni pubbliche fungono da fonte fissa di casualità, il che significa che né il Prover né il Verifier controllano l'output dell'hash. Infine prendiamo per farlo corrispondere a una scelta di colonne .
Il Prover invia i commitment e le risposte per tutti i round. Tutte queste informazioni compongono la prova . Il Verifier ricalcola i challenge per ogni round, verifica le risposte e i commitment, e accetta o rifiuta la prova.
Perché funziona? Stiamo usando la proprietà di binding dei commitment per garantire che il Prover non possa cambiare gli input precedenti una volta generato il challenge. Tutti i challenge dipendono dai commitment precedenti e, poiché eseguiamo il protocollo per round, garantiamo la solidità con altissima probabilità.
Questo è fantastico, e ora ci basta un solo messaggio per convincere un Verifier. C'è però ancora un problema: questo richiede parecchi dati. Nota come ogni prova richieda commitment, oltre a risposte, dove n è il numero di variabili e è il numero di round. Se abbiamo un numero significativo di variabili, e se è all'incirca 100, il risultato è una prova piuttosto grande.
Sfortunatamente, con gli strumenti che abbiamo a disposizione non riusciremo a rendere questa prova più succinta. Per farlo, dovremo aggiungere altri strumenti alla nostra cassetta degli attrezzi. Ma questo è un discorso per un'altra volta. Ne parleremo verso la fine dell'articolo.
Se sei interessato a come si passa dai circuiti booleani ai circuiti aritmetici, consulta l'Appendice B. Ora vediamo come ZKBoo si inserisce nel più ampio panorama delle ZKP.
Esercizi
- In un protocollo sigma con 3 quote, dove due quote vengono rivelate, qual è la probabilità che un Prover che imbroglia riesca a convincere un Verifier in un singolo round? In che modo eseguire più round aiuta?
- Se il Prover sapesse in anticipo quali colonne un Verifier sceglierebbe, come potrebbe imbrogliare?
- In Fiat-Shamir, perché fare l'hash di tutti i commitment prima di generare il challenge rende più difficile imbrogliare?
zkSNARK
Spiega il collegamento tra la ZKP di cui sopra e gli zkSNARK (Zero-Knowledge Succinct Non-Interactive ARguments of Knowledge, argomenti di conoscenza succinti, non interattivi, a conoscenza zero). Analizziamo ogni proprietà e vediamo come si collega a ZKBoo.
Potresti aver notato che abbiamo chiamato ZKBoo una ZKP (Zero Knowledge Proof, dimostrazione a conoscenza zero) e non uno zkSNARK, un termine che forse hai già sentito nominare. Anche se non tutti usano questi termini in modo corretto 28, è utile capire a cosa si riferisce ciascuna di queste proprietà.
Colloquialmente chiamiamo le ZKP "prove". Tecnicamente parlando, sono ARgomenti di Conoscenza. La distinzione ha a che fare con la natura della solidità. Abbiamo visto in precedenza come i protocolli sigma ci abbiano dato completezza, solidità e conoscenza zero. Insieme, le proprietà di completezza e solidità ci danno gli "ARgomenti di Conoscenza". In pratica, ci affidiamo alla solidità computazionale, il che tecnicamente ne fa un argomento di conoscenza e non una prova. 29
Abbiamo già trattato la proprietà di Conoscenza zero: non riveliamo nulla del nostro witness al Verifier. Curiosamente, molti progetti "ZK" e "zkSNARK" in pratica non offrono davvero la proprietà di "conoscenza zero". Un termine più accurato da usare, allora, sarebbe probabilmente calcolo verificabile e (S)NARK, ma suona meno sexy.
Abbiamo già trattato la proprietà non interattiva (la "N" di zkSNARK). Si scopre che possiamo prendere praticamente qualsiasi ZKP e renderla non interattiva usando la trasformazione di Fiat-Shamir. È comune iniziare definendo un protocollo sigma interattivo, per poi renderlo non interattivo in un secondo momento usando Fiat-Shamir.
Infine, la proprietà di cui non abbiamo ancora parlato è la succintezza. Questo significa due cose: (a) la prova è breve, e (b) la prova è veloce da verificare. Sfortunatamente, questa è una proprietà che manca a ZKBoo. Per ottenere questa proprietà, avremo bisogno di strumenti matematici più avanzati. In particolare, avremo bisogno di polinomi e di crittografia su curve ellittiche. Approfondiremo questo aspetto in un articolo futuro.
Per maggiori dettagli matematici (ancora informali), vedi l'Appendice C.
Diamo un'occhiata un po' più da vicino alla succintezza e a ZKBoo, per capire meglio cosa sta succedendo.
Sulla succintezza
Perché ZKBoo non è succinto? Quando parliamo di succintezza, ci riferiamo a due proprietà distinte:
- Dimensione succinta della prova: la prova è breve
- Tempo di verifica succinto: la prova è veloce da verificare
Di solito queste proprietà si presentano insieme, ma le analizziamo separatamente 30.
Concentriamoci prima su quanto è grande la prova. Abbiamo notato in precedenza che ogni prova richiede alcuni commitment e risposte proporzionali a , dove n è il numero di vincoli, ovvero la dimensione del circuito, . Quando diciamo che una prova è breve, ci interessa soprattutto come la dimensione cambi in funzione del numero di vincoli. Per dimensione intendiamo quanti dati devono essere inviati, il che in pratica è correlato al numero totale di byte necessari per rappresentare una prova.
Spesso usiamo la notazione Big-Oh (scritta anche Big-O, o "O grande") per descrivere quanto bene si comporta una funzione al crescere del numero di elementi su cui opera 31. Nel caso di ZKBoo, la dimensione della prova cresce linearmente con il numero di vincoli, ovvero in notazione Big-Oh. Per esempio, se il circuito ha vincoli, la prova richiede all'incirca 1000 commitment e risposte.
Con la notazione Big-Oh possiamo parlare di ordine di approssimazione senza impantanarci nei dettagli 32. Ecco un'illustrazione di alcune classi comuni di complessità:
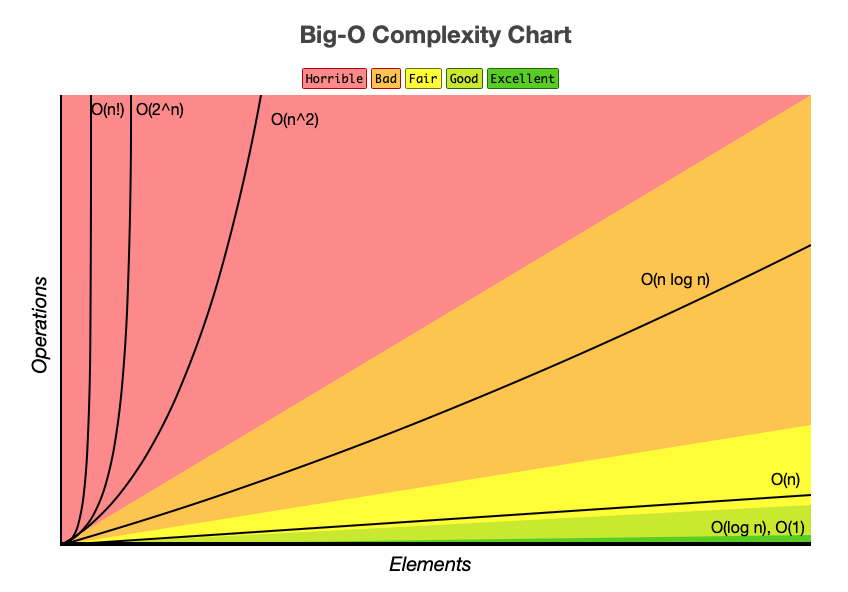
Affinché una prova sia succinta, deve idealmente essere "sublineare". Cosa significa sublineare? Tutto ciò che è strettamente "al di sotto" di nel grafico qui sopra . Per esempio, (logaritmico) oppure (costante) 31, 33.
Intuitivamente, questo significa che, man mano che aggiungiamo altri vincoli, la dimensione della prova aumenta sempre meno. La prestazione migliore è , dove la dimensione della prova resta la stessa indipendentemente dal numero di vincoli.
Che dire del tempo necessario per verificare la prova? Il Verifier deve eseguire verifiche di coerenza per tutti i vincoli. Questo equivale essenzialmente a rivalutare l'intero circuito. Questo significa che il tempo di verifica è lineare, ovvero O dove n è il numero di vincoli . Quindi, ZKBoo non ha un tempo di verifica sublineare. Qui il tempo corrisponde al numero di operazioni che un Verifier deve eseguire, e in pratica è correlato all'effettivo "clock time". Perciò, ZKBoo non ha un tempo di verifica succinto.
Spesso vogliamo la succintezza, perché significa che possiamo dimostrare un calcolo arbitrario in poco spazio (e rapidamente). Perché ZKBoo non ce la offre, e cosa si può fare al riguardo?
Fondamentalmente, il problema è che gli strumenti che stiamo usando sono troppo primitivi. Con il nostro attuale schema di commitment e la condivisione del segreto, dobbiamo rappresentare e valutare tutti i vincoli. Ciò che possiamo fare, invece, è usare i polinomi per comprimere i nostri vincoli in uno spazio più piccolo. Questo porta all'idea degli schemi di commitment polinomiale. Ma questa è una storia per un'altra volta.
Prossimi passi
Anticipazioni su cosa viene dopo, con polinomi, succintezza, PCS, IOP, confronto; il tutto per una lunga pausa caffè oppure per il prossimo articolo.
Abbiamo visto come costruire una ZKP non interattiva end-to-end con ZKBoo. Questo ci offre un'ottima base per comprendere il panorama più ampio degli zkSNARK.
Ecco alcune cose che ci aspettano più avanti:
- Capire l'importanza dei polinomi e come questi permettano la succintezza
- Generalizzare i commitment in schemi di commitment polinomiale (PCS)
- Generalizzare il protocollo sigma in una polynomial interactive oracle proof (IOP)
- Capire il quadro di riferimento PCS + Poly-IOP per i sistemi ZKP moderni
- Diversi PCS: KZG/FRI/IPA
- Capire i diversi domini: dimostrazione lato server vs lato client
- Comprendere a fondo i diversi assi di valutazione: dimensione del campo, post-quantistico, setup, assunzioni di sicurezza
- Come le blockchain pubbliche possono essere usate per verificare le prove
- Perché gli STARK sono SNARK
- Circuiti strutturati vs non strutturati
- Altre ZKP innovative
Non approfondiremo questi argomenti allo stesso livello, ma ti forniremo risorse sufficienti per sentirti sicuro di poter (a) approfondire ulteriormente, oppure (b) scegliere uno zkSNARK adatto alle tue esigenze specifiche.
Esercizi
- Quali proprietà otteniamo da ZKBoo?
- Perché ZKBoo non è succinto? Intuitivamente parlando.
Problemi
Questi sono problemi opzionali che richiederanno un po' più di impegno.
- Implementa più round in SageMath (vedi Appendice A)
- Implementa Fiat-Shamir in SageMath (vedi Appendice A)
- Trova alcuni sistemi di dimostrazione di cui hai sentito parlare. Individua in cosa si somigliano e in cosa differiscono tra loro. Confrontali con ZKBoo.
Conclusione
Riepilogo di quanto abbiamo trattato.
In questo articolo siamo partiti da una comprensione di base delle ZKP e da un bagaglio matematico minimo. Abbiamo poi introdotto concetti chiave come i circuiti, la completezza funzionale, i commitment, la condivisione del segreto e i protocolli sigma.
Abbiamo poi preso questi concetti chiave e visto come usarli per costruire una ZKP ZKBoo. Abbiamo esaminato un insieme di vincoli e visto come dimostrarli, partendo da un semplice vincolo di addizione. Abbiamo visto come farlo funzionare per più vincoli, e come sfruttiamo la casualità nei vincoli di moltiplicazione. Abbiamo analizzato la sicurezza del protocollo e migliorato la sua solidità eseguendolo più volte. Poi abbiamo reso il tutto non interattivo usando Fiat-Shamir.
Successivamente, siamo entrati un po' più a fondo in alcuni argomenti specifici. Abbiamo visto come generalizzare i circuiti booleani in circuiti aritmetici usando campi finiti, e abbiamo passato in rassegna le proprietà degli zkSNARK e come si applicano a ZKBoo. Abbiamo sviluppato un'intuizione sul perché ZKBoo non raggiunge la succintezza. Infine, abbiamo accennato ad alcuni argomenti più avanzati che potremo esplorare più avanti.
Se vuoi approfondire la tua comprensione, una buona idea è dare un'occhiata agli snippet di codice (Appendice A) e vedere come puoi estenderli o modificarli. Se qualcosa non ti è stato chiaro, non esitare a contattarci! Buona fortuna per il tuo percorso nel mondo ZK, e a presto.
Ringraziamenti
Grazie a Hanno Cornelius, dmpierre, Aayush Gupta, Adrian Li, Chih-Cheng Liang e r4bbit per aver letto le bozze e aver fornito un riscontro su questo articolo.
Immagini
- Big O cheatsheet - Eric Rowell, Pubblico dominio, tramite Wikimedia Commons
Appendice A: codice ZKBoo
Quanto segue è un esempio di codice che implementa ZKBoo in modo conciso in SageMath.
È disponibile un repository di codice qui: https://github.com/oskarth/zkintro-math
Mostra un'implementazione dei vari costrutti specificati sopra in questo articolo. Anche se non è necessario, può essere utile mappare le equazioni matematiche al codice vero e proprio. È implementato in SageMath, un software matematico basato su Python. Si legge sostanzialmente come pseudocodice e ci permette di esprimere in modo conciso la matematica come codice.
Nel repository abbiamo i seguenti esempi:
commitments_shares.sage- commitment e condivisione del segreto di basezkboo_add.sage- vincolo di addizione di base in ZKBoozkboo_mul.sage- vincolo di addizione e moltiplicazione di base in ZKBoo
Estendere quanto sopra per supportare più round e la trasformazione di Fiat-Shamir è per ora lasciato come esercizio al lettore.
Nel complesso, il protocollo ZKBoo può essere espresso comodamente in meno di 100 righe di codice 34. Una volta che esiste un prototipo matematico in Sage, diventa molto più facile poi "portarlo" su qualcosa come Python, JavaScript, Rust o Go per un uso nel mondo reale.
Lo snippet di codice seguente (zkboo_mul.sage) mostra la completezza funzionale per un round di ZKBoo interattivo in 60 righe di codice con i commenti. Può essere esteso per usare più round e reso non interattivo con Fiat-Shamir in meno di 100 righe di codice.
import random, hashlib
from sage.all import GF

p = 101  # Prime field modulus
F = GF(p)  # Finite field

def secret_share(v):
    """Split 'v' into 3 random shares mod p."""
    s1, s2 = F.random_element(), F.random_element()
    return [s1, s2, (v - s1 - s2) % p]

def commit(vals):
    """Hash tuple of values to produce a commitment."""
    return hashlib.sha256(",".join(map(str, vals)).encode()).hexdigest()

def multiply_shares(a, b):
    """Compute c_i for a single gate a*b=c with offsets r_i."""
    r = [F.random_element() for _ in range(3)]
    c = [(a[i] * b[i] + a[i] * b[(i + 1) % 3] +
          a[(i + 1) % 3] * b[i] + r[i] - r[(i + 1) % 3]) % p
         for i in range(3)]
    assert sum(c) % p == (sum(a) * sum(b)) % p
    return c, r

def zkboo_prover(a, b, d):
    """Generate shares for a,b,d and compute c=a*b, e=c+d with random offsets."""
    a_sh, b_sh, d_sh = secret_share(a), secret_share(b), secret_share(d)
    c_sh, r_sh = multiply_shares(a_sh, b_sh)
    e_sh = [(c_sh[i] + d_sh[i]) % p for i in range(3)]
    commits = [commit((a_sh[i], b_sh[i], c_sh[i], d_sh[i],
                       e_sh[i], r_sh[i])) for i in range(3)]
    return a_sh, b_sh, c_sh, d_sh, e_sh, commits, r_sh

def zkboo_verifier_challenge():
    """Pick two random shares to reveal."""
    return random.sample(range(3), 2)

def zkboo_prover_response(ch, a, b, c, d, e, r):
    """Reveal the requested two shares with all data."""
    return [{"a": a[i], "b": b[i], "c": c[i], "d": d[i],
             "e": e[i], "r": r[i]} for i in ch]

def zkboo_verify(ch, resp, commits):
    """Check commitments and verify correctness of revealed shares."""
    if any(commit((resp[i]["a"], resp[i]["b"], resp[i]["c"],
                   resp[i]["d"], resp[i]["e"], resp[i]["r"]))
           != commits[ch[i]] for i in range(2)):
        return False

    def check_c(sh_i, sh_j):
        """Ensure multiplication consistency of revealed shares."""
        return (sh_i["a"] * sh_i["b"] + sh_i["a"] * sh_j["b"] +
                sh_j["a"] * sh_i["b"] + (sh_i["r"] - sh_j["r"])) % p == sh_i["c"]

    # Check correct share pairs are used for verification
    if (ch[0] + 1) % 3 == ch[1] and not check_c(resp[0], resp[1]):
        return False
    if (ch[1] + 1) % 3 == ch[0] and not check_c(resp[1], resp[0]):
        return False
    return all((share["c"] + share["d"]) % p == share["e"] for share in resp)

def test_zkboo_single_round():
    """Test a single-round reveal for a,b,d = 3,4,5."""
    a, b, d = F(3), F(4), F(5)
    a_sh, b_sh, c_sh, d_sh, e_sh, commits, r_sh = zkboo_prover(a, b, d)
    ch = zkboo_verifier_challenge()
    resp = zkboo_prover_response(ch, a_sh, b_sh, c_sh, d_sh, e_sh, r_sh)
    assert zkboo_verify(ch, resp, commits), "ZKBoo single-round failed"
    print("Single-round test passed!")

test_zkboo_single_round()
Appendice B: circuiti aritmetici
Questa sezione spiega come generalizzare i circuiti booleani visti sopra ai circuiti aritmetici.
In matematica esiste un ramo chiamato algebra astratta. Si occupa di diverse strutture algebriche e delle operazioni definite su di esse. Per esempio, abbiamo cose come l'insieme dei numeri naturali o l'insieme dei numeri interi:
Combiniamo questi insiemi con alcune operazioni, come l'addizione o la moltiplicazione, che funzionano in un modo particolare. Con questo possiamo parlare di strutture come insiemi, gruppi, anelli e campi. Le definizioni precise di queste strutture per ora non sono così importanti. L'idea chiave è che ogni struttura aggiunge nuove possibilità:
I campi, in particolare, permettono la divisione (tranne che per lo zero). Questo perché esiste un inverso moltiplicativo per ogni elemento di un campo. Da notare che questo non vale per l'insieme dei numeri interi con addizione e moltiplicazione, indicato con 35.
Per esempio, l'inverso moltiplicativo di è (poiché ), che non esiste in , perché non è un numero intero 36. Se parlassimo dell'insieme dei numeri reali, , andrebbe bene perché vi appartiene, quindi è un campo.
I computer, tuttavia, funzionano su hardware e noi operiamo su numeri finiti. Quindi, quando si parla di crittografia, siamo interessati ai campi finiti. Cioè, un campo con un insieme finito di elementi. Per esempio:
Molti protocolli crittografici richiedono la divisione e un'aritmetica modulare ben definita. Si scopre che possiamo costruire un campo finito restringendolo semplicemente , dove è un numero primo 37. Lo scriviamo sia come sia come . sta per Galois Field (campo di Galois), un altro nome per i campi finiti 38.
Nell'esempio sopra, se escludiamo (poiché la divisione per non è permessa; indicato con ), abbiamo:
Possiamo vedere che ogni elemento ha un inverso moltiplicativo nell'insieme. Per esempio, .
Nel protocollo ZKBoo visto sopra, usiamo , il campo finito più semplice, per i circuiti booleani. I circuiti aritmetici generalizzano questo a , dove è un numero primo. Questo significa che tutte le operazioni, addizione e moltiplicazione, vengono eseguite , garantendo che i valori restino all'interno di quel campo. Questo ci permette di lavorare con numeri maggiori di 0 e 1. In questo campo, addizione e moltiplicazione funzionano bene, quindi possiamo eseguire un'aritmetica modulare ben definita. Possiamo usare i numeri interi come ci aspettiamo, purché siano limitati, cioè minori di un numero primo specifico. In pratica, usiamo spesso numeri primi molto grandi 39. Questo significa che possiamo esprimere numeri molto grandi e la relativa aritmetica in modo ben definito.
Appendice C: definizioni matematiche degli zkSNARK
Rendiamo un po' più precisa la sezione qui sopra sugli zkSNARK, pur mantenendola matematicamente informale 40. Sentiti libero di saltare questa appendice se sei soddisfatto del testo principale.
Completezza - per tutti gli in la probabilità che il Verifier V accetti la prova del Prover è 1. Ovvero:
Solidità - V accetta la prova P "conosce" tale che , e se la prova è falsa, 41
Conoscenza zero - ) con la prova non rivela nulla su
Succintezza - la prova è "breve" e è "veloce" da verificare.
"Breve" ha definizioni diverse, ma di solito significa , dove è la dimensione del witness 33.
"Veloce da verificare" significa , dove significa "ordine di" nella notazione Big-Oh 31, e è la dimensione del circuito.
A volte un andamento quasi-lineare, per esempio , è accettato come "abbastanza succinto".
Non interattivo - È sufficiente che il Prover invii al Verifier per convincerlo; il Verifier può verificare la prova con e . 42
Riferimenti
Footnotes
-
Per laureato STEM si intende chi ha studiato Scienza, Tecnologia, Ingegneria o Matematica in un'università o istituto equivalente. ↩
-
Per esempio usando un motore di ricerca, un LLM (Large Language Model, modello linguistico di grandi dimensioni; per esempio strumenti di IA come ChatGPT), oppure un amico. Per esempio, potresti chiedere a un LLM di spiegarti un concetto specifico con un ELI5 (Explain Like I'm Five, letteralmente "spiegamelo come se avessi cinque anni"). ↩
-
L'idea di usare ZKBoo per spiegare le ZKP si deve ad Aayush Gupta, sulla base della sua precedente esperienza (video). Puoi anche leggere il paper originale, anche se risulta un po' ostico. Anche Geometry Research ha un post che spiega il protocollo, ma richiede più conoscenze di base per essere compreso. ↩
-
SageMath è un sistema matematico costruito sopra Python che ci permette di concentrarci sull'essenziale. Si legge come pseudocodice, traducendo in modo naturale i simboli matematici in codice. ↩
-
Se sono numeri primi grandi, allora è molto difficile ricavarli a partire dall'output pubblico . ↩
-
Si presume che le variabili intermedie siano definite, ma si tratta di un dettaglio implementativo; come sistema di equazioni, è semplicemente un'altra variabile incognita che viene determinata dagli altri vincoli. Per esempio, potremmo scrivere altrettanto bene l'insieme di vincoli sopra come . ↩
-
Le variabili intermedie sono a volte chiamate anche variabili interne (internal variables), e sono più che altro un dettaglio implementativo. Vale la pena notare che sono note solo al Prover, poiché potrebbero lasciare trapelare informazioni sugli input privati. ↩
-
Esistono diversi modi di esprimere questo insieme di equazioni, come R1CS, Plonkish, ecc. Chiamiamo questo processo aritmetizzazione. ↩
-
Anche se non è identico, il concetto di completezza funzionale è collegato a quello di completezza di Turing. ↩
-
Vedi il libro Elements of Computing Systems (Nisan, 2005) e il corso associato From Nand to Tetris. C'è anche un libro chiamato But How Do It Know? (Scott, 2009) che spiega come funzionano i computer partendo dall'algebra booleana. ↩
-
Interi delimitati da per un certo numero primo . Vedi l'Appendice B per maggiori dettagli. ↩
-
Vedi Programmare le ZKP: From Zero to Hero. Non è un requisito, ma potrebbe rendere più chiaro il collegamento tra matematica e codice. ↩
-
Vedi funzioni di hash crittografiche per maggiori dettagli. Esistono molte funzioni di hash di questo tipo, ma SHA256 è una delle più utilizzate. ↩
-
Tecnicamente parlando, dati solo e , sia sia restano indeterminati, il che significa che abbiamo due gradi di libertà. L'equazione è sottodeterminata, perché ci sono più incognite che valori noti. ↩
-
Il calcolo multi-party (MPC) è in realtà un'area distinta dalla ZK. Un modello mentale utile è che l'MPC si occupa di segreti condivisi tra più partecipanti, mentre la ZK si occupa dei segreti di una singola persona. ↩
-
In alternativa, in , se conosci e due delle altre parti puoi ricostruire la terza, dato che . Nella metafora del puzzle, questo corrisponderebbe ad avere due pezzi su tre e sapere che aspetto dovrebbe avere l'immagine finale, anche se manca un pezzo. ↩
-
Potresti dover strizzare gli occhi per vederlo: le punte delle frecce in alto e in basso formano la parte superiore e inferiore della Sigma, e la punta della freccia al centro forma la parte centrale. ↩
-
Probabilmente l'esempio più canonico di protocollo sigma è la dimostrazione della conoscenza del logaritmo discreto. Anche se è "più semplice", richiede un po' più di basi matematiche per essere compreso. Inoltre non ci avvicina alla comprensione di ZKBoo, quindi omettiamo questo esempio. ↩
-
La maggior parte dei protocolli sigma possiede tutte e tre le proprietà, ma alcuni non hanno la proprietà di conoscenza zero. ↩
-
Le ragioni sono due: ZKBoo è arrivato più tardi rispetto ad altri protocolli, e le sue prove non sono succinte. Ne vedremo di più verso la fine dell'articolo. ↩
-
Vedremo presto più nel dettaglio la nozione di solidità. ↩
-
Con tutti i calcoli eseguiti . Vedi l'Appendice B per i dettagli. ↩
-
Nell'esempio del vincolo di moltiplicazione, dato che viene effettivamente verificata una sola colonna, questo significa che la probabilità di imbrogliare, assumendo solo vincoli di moltiplicazione, è . Intuitivamente, la maggior parte degli esempi del mondo reale avrebbe un mix di addizione e moltiplicazione, ed è sufficiente che una sola verifica di coerenza fallisca per essere scoperti. Vedi il paper originale per un'analisi più precisa della solidità. ↩
-
Nella pratica, spesso parliamo dell'errore di solidità in termini di bit di sicurezza di un protocollo. Questo indica quanto sia difficile violare un protocollo e quindi quanto sia sicuro. Per ZKBoo, se vogliamo avere 80 bit di sicurezza, dobbiamo eseguire 137 round. Questo può essere calcolato usando . Vedi il paper per i dettagli. ↩
-
Cioè, appaiono statisticamente casuali nonostante siano generati da un processo deterministico. Vedi pseudocasualità. ↩
-
Vedi seed casuale. ↩
-
Esistono molti modi per commettere errori con Fiat-Shamir nella pratica, vedi Fiat-Shamir in the Wild (paper), e How to Prove False Statements (paper). ↩
-
Del tipo "tecnicamente corretto, il miglior tipo di corretto". Per esempio, molti progetti "ZK" non usano effettivamente la proprietà di conoscenza zero! ↩
-
La solidità computazionale significa che uno schema è sicuro contro un avversario con risorse computazionali limitate. Una prova statisticamente solida reggerebbe anche contro un avversario "illimitato". Quest'ultimo caso è più raro nella crittografia del mondo reale. Questo può diventare piuttosto complesso nella letteratura accademica, con diverse nozioni di solidità - computazionale, statistica, simulata, estraibilità ecc. Le sottigliezze di queste distinzioni esulano dall'ambito di questo articolo, e non sono qualcosa di cui la maggior parte delle persone deve preoccuparsi, a meno che tu non voglia diventare un crittografo a tempo pieno. ↩
-
Anche se meno comune, esistono sistemi di dimostrazione che sono succinti solo in una di queste dimensioni. Per esempio, Bulletproofs ha prove succinte ma un tempo di verifica lineare. ↩
-
Questo è un termine della teoria della complessità computazionale. Parliamo di quanto qualcosa sia veloce o lento in funzione del suo input. Potremmo dire che O(1) significa che è "costante", oppure che O(n) significa che è "lineare", ecc. Sublineare significa meno che lineare, per esempio . Vedi notazione Big-O e Big O Notation Tutorial per maggiori dettagli. ↩ ↩2 ↩3
-
Per esempio, non importa se dobbiamo eseguire operazioni oppure operazioni: queste funzioni sono entrambe , ovvero dell'ordine di . ↩
-
Nella pratica, molte prove sono logaritmiche, . A volte va bene anche un andamento quasi-lineare, , e viene comunque considerato "abbastanza succinto". Il caso migliore è , ma spesso comporta altri compromessi. Esempi di sistemi di dimostrazione succinti sono Groth16 e Plonk. Anche le costanti contano, specialmente quando si tratta di verifica on-chain. Ma questo esula dall'ambito di questo articolo. Vedi ad esempio le motivazioni per cui Groth16 o i commitment KZG sono spesso usati in Ethereum. ↩ ↩2
-
Nel senso di esprimere gli algoritmi principali, non di offrire una gestione degli errori completa, una buona API, buone prestazioni ecc. ↩
-
è un anello; più precisamente è un anello commutativo (o abeliano) poiché la moltiplicazione è commutativa (). ↩
-
Qui chiamiamo l'elemento neutro . Esiste sia per l'addizione (di solito 0), sia per la moltiplicazione (di solito 1). Vedi definizione di campo per saperne di più. ↩
-
E quelli che vengono chiamati campi di estensione primi (prime extension fields), come . ↩
-
Nella crittografia applicata e nell'informatica, la notazione è più comune, mentre in matematica pura è più comune . Il nome Galois Field (campo di Galois) è in onore del matematico francese Galois, che li scoprì. Gettò le fondamenta dell'algebra astratta, e morì in duello all'età di 20 anni. ↩
-
Per esempio . La scelta precisa del numero primo è un argomento più approfondito, con nozioni come la pairing-friendliness (compatibilità con il pairing), specialmente quando si tratta di sistemi crittografici. Vedi per esempio perché è stato scelto BN254 in Zcash. ↩
-
In questa spiegazione saltiamo la nozione di un passaggio di setup di preprocessing , con i parametri del Prover () e i parametri del Verifier (. Di solito questo è incluso nelle definizioni, ma non ci serve in ZKBoo. ↩
-
Non entreremo nei dettagli precisi di cosa significhi "conoscere" il witness qui, perché richiede la comprensione di nozioni come la solidità della conoscenza adattiva (adaptive knowledge soundness) e gli estrattori, che non sono necessarie per avere una comprensione concettuale della nozione di solidità statistica. Se vuoi approfondire, il libro di Thaler o i corsi di Boneh sono buone risorse. Vedi anche la nota 29. ↩
-
Così come altre informazioni predeterminate, come l'algoritmo di challenge di Fiat-Shamir, ed eventualmente alcune "verification key", cioè chiavi di verifica (anche se non nel caso di ZKBoo). ↩